Wacana OpenAI menyematkan watermark tersembunyi pada teks ChatGPT memicu perdebatan sengit. Meski akurat pada teks mentah, jejak algoritma ini terbukti anjlok drastis begitu diparafrase atau diedit secara manual
ChatGPT Bakal Beri Watermark Tersembunyi di Teks yang Dicopy! Ini Cara Hilangkannya
Rencana OpenAI untuk menyematkan penanda digital pada setiap jawaban yang dihasilkan model bahasanya bukan lagi sekadar rumor laboratorium. Wacana seputar watermark tersembunyi ChatGPT telah memicu perdebatan panas di kalangan kreator konten, akademisi, hingga praktisi industri teknologi. Banyak pihak khawatir teks yang disalin langsung dari antarmuka ChatGPT akan otomatis terendus oleh alat pendeteksi kampus maupun mesin pencari Google.
Namun, di balik kecemasan tersebut, terdapat realitas teknis yang jarang dibahas secara tuntas: penanda berbasis statistik ini memiliki kelemahan struktural yang fatal. Begitu teks mengalami sedikit sentuhan penyuntingan atau parafrase, tingkat akurasi deteksi watermark langsung anjlok bebas ke titik yang tidak lagi reliabel.
Memahami Watermark Teks: Bukan Karakter Gaib, Melainkan Pola Probabilitas
Banyak orang mengira OpenAI menyisipkan karakter tersembunyi seperti zero-width space atau kode biner tak kasat mata di antara huruf saat pengguna menekan tombol salin (copy). Asumsi ini keliru. Trik semacam itu terlalu rapuh karena karakter gaib dapat dibersihkan seketika dengan aplikasi teks sederhana seperti Notepad atau terminal peramban.
Teknologi penandaan yang dikembangkan OpenAI beroperasi jauh lebih dalam, yakni langsung pada level probabilitas pemilihan kata (token).
Proyek riset yang dipimpin oleh ilmuwan komputer Scott Aaronson di OpenAI memanfaatkan pendekatan kriptografi statistik. Saat sebuah model bahasa besar (Large Language Model / LLM) menyusun kalimat, model tersebut memprediksi kata berikutnya dari ribuan kandidat token yang tersedia. Setiap token memiliki bobot probabilitas masing-masing.
Secara berkala, algoritma watermarking membagi perbendaharaan kata ke dalam dua kelompok rahasia: green list (daftar hijau) dan red list (daftar merah). Pembagian ini ditentukan oleh rumus matematika semu (pseudorandom function) yang dipicu oleh token kata sebelumnya.
Model diprogram secara halus untuk memprioritaskan kata-kata dari green list, tanpa merusak koherensi makna kalimat secara drastis. Manusia biasa yang membaca teks tersebut tidak akan merasakan kejanggalan linguistik. Namun, alat pemindai milik OpenAI yang memegang kunci enkripsi dapat menghitung rasio kata dari green list. Jika sebuah paragraf memiliki proporsi kata green list yang secara statistik mustahil muncul secara kebetulan dari tulisan manusia, sistem akan menyimpulkan dengan kepastian 99% bahwa teks tersebut adalah produk ChatGPT.
Dilema Internal OpenAI: Mengapa Fitur Ini Belum Dirilis Bebas?
Teknologi penandaan token ini sebenarnya telah siap diterapkan di sisi server. Namun, laporan internal industri mengungkap bahwa manajemen OpenAI menghadapi dilema bisnis yang cukup berat.
Penyematan penanda permanen berisiko mengusir jutaan pengguna aktif harian, terutama mereka yang memanfaatkan kecerdasan buatan untuk membantu menyusun draf dokumen kerja, materi presentasi, naskah iklan, maupun esai akademik. Survei internal menunjukkan bahwa sebagian besar pengguna ChatGPT Plus enggan memperbarui langganan jika teks yang mereka salin membawa "stempel tak kasat mata" yang rentan memicu sanksi akademik atau penalti algoritma mesin pencari.
Selain faktor retensi pengguna, OpenAI menghadapi kendala diskriminasi bahasa. Watermark berbasis token bekerja efektif pada teks berbahasa Inggris yang kaya sinonim, tetapi kerap menurunkan kualitas tata bahasa ketika diterapkan pada bahasa dengan variasi kata terbatas atau struktur gramatikal kaku.
Mengapa Akurasi Watermark Anjlok Begitu Teks Diedit?
Alasan paling mendasar mengapa sistem penanda teks ini sulit menjadi instrumen hukum yang mutlak adalah kerentanannya terhadap intervensi manusia. Tingkat keberhasilan deteksi watermark tersembunyi ChatGPT anjlok drastis ketika pola matematis antar-token terputus.
Penelitian independen dari berbagai institusi, termasuk Universitas Maryland, membuktikan bahwa ketahanan (robustness) watermark berbasis LLM sangat bergantung pada keutuhan rantai kata (n-gram sequence). Ketika rantai tersebut diacak, sinyal deteksi melemah secara eksponensial.
Berikut faktor utama yang membuat skor deteksi watermark merosot tajam:
- Pemutusan Rantai Token: Pergantian satu kata kunci di tengah kalimat merusak referensi penentuan green list untuk dua hingga tiga kata berikutnya. Akibatnya, korelasi statistik yang dicari alat pemindai langsung hilang.
- Perubahan Struktur Kalimat: Mengubah kalimat aktif menjadi pasif, atau membalik urutan klausa, membongkar tatanan probabilitas awal yang ditanamkan oleh model.
- Tingkat Entropi Campuran: Ketika kalimat buatan mesin disisipi kalimat murni tulisan tangan manusia, skor akumulasi green list melorot ke batas abu-abu (inconclusive), sehingga alat deteksi tidak berani mengambil kesimpulan pasti demi menghindari tuduhan keliru (false positive).
Cara Menghilangkan Jejak Watermark pada Teks Salinan
Jika OpenAI pada akhirnya mengaktifkan fitur penandaan ini secara baku (default), pengguna tidak perlu panik. Anda tidak membutuhkan perangkat lunak peretas rumit untuk menetralkannya. Cukup terapkan metode penyuntingan terstruktur untuk mengembalikan keaslian gaya penulisan:
1. Teknik Restrukturisasi Manual (Metode Paling Aman)
Gunakan draf yang dihasilkan AI hanya sebagai kerangka ide atau bahan mentah, bukan hasil akhir yang langsung dipublikasikan.
- Baca ulang paragraf secara utuh, lalu tuliskan kembali gagasan intinya menggunakan sudut pandang dan kosakata Anda sendiri.
- Potong kalimat panjang yang bertele-tele khas LLM menjadi dua kalimat pendek yang lugas.
- Ganti kata transisi generik seperti "selain itu", "di sisi lain", atau "perlu dicatat" dengan alur dialogis yang lebih natural.
2. Metode Round-Trip Translation (Penerjemahan Bolak-Balik)
Mekanisme penerjemahan antarbahasa secara efektif merombak seluruh struktur token:
- Terjemahkan draf teks ke dalam bahasa dengan struktur tata bahasa yang jauh berbeda, misalnya bahasa Jerman, Prancis, atau Jepang.
- Terjemahkan kembali teks tersebut ke bahasa asal menggunakan mesin penerjemah independen seperti DeepL.
- Lakukan sedikit penyesuaian lokal agar diksi terasa luwes. Karena kamus kata dan urutan sintaksis telah ditata ulang oleh mesin penerjemah, seluruh penanda probabilitas green list bawaan ChatGPT otomatis lenyap.
3. Modifikasi Format dan Penggabungan Data Nyata
Alat pendeteksi kerap memanfaatkan konsistensi gaya teks. Anda dapat mengaburkan sinyal tersebut dengan menyuntikkan data empiris konkret:
- Sisipkan referensi nama tokoh, kutipan langsung wawancara, angka statistik terbaru, atau analogi personal yang tidak ada pada basis data bawaan ChatGPT.
- Ubah format paragraf menjadi dialog tanya-jawab singkat atau studi kasus spesifik.
Lanskap Baru Pendeteksian Teks AI
Upaya OpenAI mengamankan teks keluarannya mencerminkan eskalasi perlombaan tanpa akhir antara pengembang sistem deteksi dan fleksibilitas bahasa manusia. Teks bukanlah deretan piksel foto atau berkas audio yang memiliki metadata frekuensi tetap. Bahasa adalah medium dinamis yang selalu berubah setiap kali diucapkan atau dituliskan kembali.
Kehadiran fitur watermark tersembunyi ChatGPT pada akhirnya menegaskan satu prinsip penting bagi para kreator: era ketergantungan pada salin-tempel mentah telah berakhir. Kunci agar karya tulis tetap aman, relevan, dan berbobot di mata mesin maupun pembaca adalah sentuhan kurasi manusia yang berani mengubah draf sintetis menjadi karya orisinal yang memiliki karakter autentik.
 Terobosan baru AI model yang berbeda dengan transformer model. Gak bisa Ngobrol!
 7 Penyedia Jasa Integrasi AI Terbaik di Jakarta
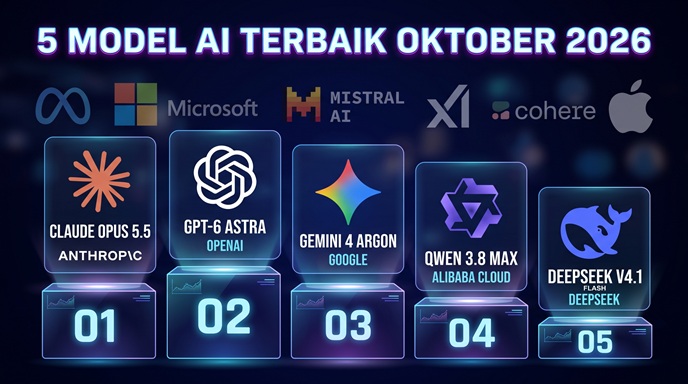 5 Model AI terbaik oktober 2026. 2 diantaranya dari China